Si le pides a un alumno que se escriba su propio examen, va a aprobar. No porque haga trampa (aunque también), sino porque las preguntas que se le ocurran serán justo las que sabe contestar. Pues precisamente eso es lo que hacemos cuando dejamos que un agente de IA escriba el código y, a la vez, los tests que dicen si ese código está bien. Y, de este modo, no hay manera de verificar código generado por IA. Las contrapruebas son mi respuesta a ese problema, y son la idea central del Desarrollo Guiado por Contrapruebas (DGC). Hasta el nombre sale de ahí.
En el artículo anterior te conté cómo organizar las specs de un sistema con capacidades y deltas, y te dejé una pregunta en el aire: ¿qué es exactamente una contraprueba y cómo se le esconde al agente? Hoy toca. Ponte cómod@, que esta tiene su miga.
El problema: el agente aprueba el examen que se ha escrito él
Cuando el mismo agente escribe el código y sus tests, el que implementa y el que comprueba comparten la misma interpretación de la tarea. Si el agente ha entendido mal un requisito, lo ha entendido mal dos veces: en el código y en el test. Y el test pasa correctamente.
Hay un segundo problema, más feo todavía. Un agente optimiza para que los tests pasen, que no es lo mismo que optimizar para que el sistema haga lo que debe. Y esto no es una sospecha mía, hay estudios que lo miden.
Te puedo asegurar que revisar a mano todo lo que genera el agente tampoco es la salida. Cuanto más produce, más tiempo pasas leyendo, y la revisión acaba siendo un vistazo en diagonal antes de darle a aprobar. Así que, para verificar código generado por IA, hace falta otra cosa: una comprobación que no dependa de quien escribe el código y que ese alguien no pueda verlo.
Qué es una contraprueba: verificar código generado por IA sin que lo vea
Una contraprueba es un ejemplo concreto y ejecutable que pone a prueba un criterio de la spec. Si el criterio es la regla, la contraprueba es una pregunta de examen sobre esa regla.
Tiene tres rasgos:
- Es de caja negra. Actúa sobre la interfaz pública del sistema en marcha (peticiones HTTP, la línea de comandos o un navegador automatizado) y no importa ni una línea del código interno.
- Se escribe con la estructura Dado / Cuando / Entonces. Yo recomiendo Gherkin, porque lo pueden leer el PO y el desarrollador y hay muchas herramientas que lo ejecutan, pero el formato concreto lo elige cada equipo.
- Lleva el ID del criterio que verifica. Es el único vínculo entre las dos cosas.
Recupero la capacidad recuperacion-password del artículo anterior. Tenía estos dos criterios:
- RP.2 El enlace deberá caducar 30 minutos después de su emisión.
- RP.3 El enlace deberá ser de un solo uso.
Y estas serían algunas de sus contrapruebas:
# language: es
Característica: Recuperación de contraseña

  @RP.2
  Escenario: Enlace usado justo antes de caducar
    Dado un enlace de recuperación emitido a las 10:00
    Cuando se usa a las 10:29
    Entonces la contraseña se puede cambiar

  @RP.2
  Escenario: Enlace caducado
    Dado un enlace de recuperación emitido a las 10:00
    Cuando se usa a las 10:31
    Entonces se rechaza por enlace caducado

  @RP.3
  Escenario: Enlace reutilizado
    Dado un enlace de recuperación ya utilizado
    Cuando se intenta usar de nuevo
    Entonces se rechaza por enlace ya usado
Fíjate en dos cosas. La primera, que RP.2 tiene dos contrapruebas, una a cada lado del límite. Lo normal es que un criterio tenga varias, sobre todo en los casos límite, que es donde se rompen las cosas. La segunda, que el criterio no es un escenario. El criterio dice la regla («caduca a los 30 minutos») y los escenarios son ejemplos de esa regla («a las 10:29 funciona, a las 10:31 no»). Si escribes los criterios directamente como escenarios, mezclas la regla con sus ejemplos y pierdes las dos cosas.
¿Te suena a BDD? Normal, porque lo es. Las contrapruebas son ejemplos como los de BDD o Specification by Example, con una diferencia que lo cambia todo: el que escribe el código no los ve.
Por qué el agente no puede ver las pruebas que verifican su código
Si has entrenado alguna vez un modelo de aprendizaje automático, esto ya lo sabes. Separas los datos en dos: con unos entrenas y con otros, que el modelo no ha visto nunca, mides. Es el holdout set. Si evalúas con los mismos datos con los que has entrenado, el modelo saca nota de sobra y luego, en producción, se la pega. Se ha aprendido las respuestas, no el problema.
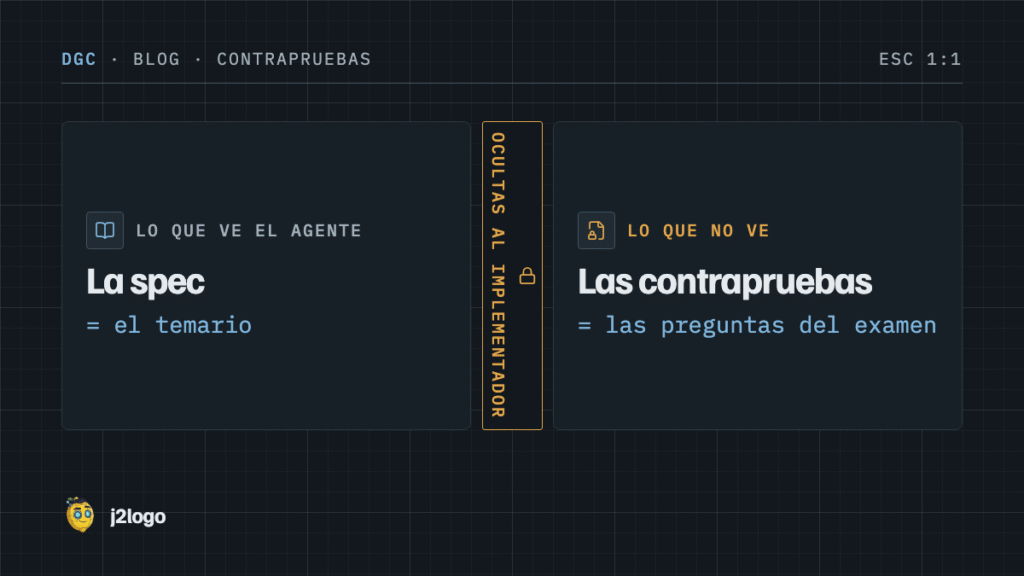
Pues una contraprueba es la traslación de esa idea a la verificación de software. El agente estudia el temario, que es la spec. Pero no conoce las preguntas del examen, que son las contrapruebas.
Esto tiene una consecuencia que no es evidente al principio: hay que tener cuidado también con lo que se le dice al agente cuando falla. Si le devuelves «el escenario Enlace caducado esperaba un rechazo a las 10:31», ya conoce la pregunta. A partir de ahí deja de ser una contraprueba y el agente empieza a ajustarse a ella, que es justo lo que queríamos evitar. Por eso en DGC el feedback habla el lenguaje de la spec, no el de la prueba: «RP.2: aceptó cuando debía rechazar». Qué criterio no se cumple, no qué ejemplo concreto ha fallado.
Ni siquiera eso es gratis. Building to the Test muestra que saber solo qué pasa y qué falla ya basta para que un agente se ajuste a las pruebas, así que los intentos tienen que ser pocos. Qué hacer cuando el agente no lo saca a la primera (y cuándo hay que acabar enseñándole la pregunta) da para un artículo entero, y lo tendrás en la serie.
Tipos de contrapruebas
Hay dos formas de clasificarlas, y conviene no mezclarlas.
Según lo que comprueban:
| Tipo | Qué verifican | Ejemplo | ¿Ocultas? |
|---|---|---|---|
| Funcionales | Criterios de aceptación | «Con un enlace caducado, la API devuelve 410» | Sí, siempre |
| Técnicas | Restricciones y decisiones técnicas | Una regla de dependencias («api no importa db»), una prueba de carga con p95 < 200 ms, un escáner de secretos | Pueden ser visibles |
¿Por qué las técnicas pueden estar a la vista? Porque en ellas la regla misma es la prueba. No hay ejemplos que memorizar. Si la contraprueba dice que el módulo api no puede importar nada de db, enseñársela al agente no le da ninguna ventaja tramposa: le estás diciendo la regla, y cumplirla es exactamente lo que quieres. Con las funcionales pasa lo contrario. Si el agente sabe que la prueba usa las 10:31, le basta con rechazar a las 10:31.
Según su origen:
| Tipo | Cuándo se escriben | Para qué |
|---|---|---|
| Diseñadas | A partir de la spec, antes de implementar | Es el caso normal |
| De caracterización | Observando lo que hace hoy un sistema que ya existe | Red de seguridad: avisan si el agente cambia un comportamiento que nadie ha documentado |
Las de caracterización son las que hacen que DGC sirva en proyectos que ya tienen años encima, no solo en los que empiezan de cero. No juzgan si el comportamiento actual es correcto, solo lo fijan. Si mañana alguien confirma ese comportamiento en la spec, la contraprueba pasa a ser diseñada.
Quién escribe las contrapruebas
Aquí va solo lo justo, porque el reparto de papeles es el tema del próximo artículo: los ejemplos los decide una persona. Los puede escribir ella o puede aprobar los que le proponga un agente, pero la decisión es suya.
¿Por qué tanto empeño, si un agente los escribe en dos segundos? Por la misma razón del principio. Si un agente genera los escenarios a partir de la spec, las contrapruebas dependen de su interpretación. Ante una spec ambigua, el agente que implementa y el que genera las pruebas pueden malinterpretarla igual, y la contraprueba pasaría tan contenta. Los ejemplos concretos son justo el punto donde el criterio humano aporta más. Traducirlos después a código ejecutable es trabajo mecánico, y eso sí lo hace otro agente.
No te voy a engañar: escribir buenos ejemplos lleva tiempo. Es el mismo trabajo de análisis que muchos equipos se saltan, y DGC no lo elimina. Lo pone encima de la mesa.
La ejecución de control: si no falla antes, no comprueba nada
Esta es la parte que más me gusta, porque es muy barata y caza muchos errores.
Antes de que el agente implementador escriba una sola línea, se ejecutan las contrapruebas nuevas contra el sistema tal y como está:
- Las de comportamiento nuevo tienen que fallar. Si todavía no has implementado la caducidad del enlace y la contraprueba de RP.2 ya pasa, esa contraprueba no está comprobando nada. Se descarta y se escribe bien.
- Las de caracterización tienen que pasar, porque describen lo que el sistema ya hace.
Si has hecho TDD, es el famoso «rojo» antes del «verde». Pero aquí tiene un papel extra. Las contrapruebas las traduce a código un agente verificador, y un paso de esos puede estar mal sin que se note: un assert que no comprueba nada, un mock que sustituye al sistema real o una comparación demasiado laxa. Una contraprueba así pasaría siempre, con el código bien o mal. La ejecución de control la delata antes de que te fíes de ella.
Hay dos comprobaciones más que van en el CI de forma continua, y que salen de que cada contraprueba lleve el ID de su criterio:
- Contrapruebas huérfanas: apuntan a un criterio que ya no existe. Se retiran.
- Criterios sin cubrir: no tienen ninguna contraprueba. Salta un aviso.
La dependencia va en un solo sentido, de la contraprueba al criterio. La spec no sabe nada de sus contrapruebas. Por eso, como te contaba en el artículo anterior, los IDs no se reutilizan nunca.
StrongDM: la referencia más cercana a las contrapruebas
No quiero vender esto como si nadie lo hubiera pensado antes. La idea de esconder los escenarios al agente que programa ya la usa el equipo de IA de StrongDM en su software factory, y es la referencia más cercana a DGC que conozco. Simon Willison lo contó en febrero de 2026.
Ellos llaman escenarios a historias de usuario de principio a fin, y las guardan a menudo fuera del código, para que los agentes que programan no las vean. Lo comparan, precisamente, con el holdout set del entrenamiento de modelos. En lugar de «los tests están en verde», miden la satisfacción: de todas las ejecuciones observadas a través de los escenarios, qué fracción probablemente deja satisfecho al usuario. Y sus reglas van a saco: el código no lo escriben personas y tampoco lo revisan personas.
Así que la idea central la compartimos. Lo que DGC añade es el método alrededor:
- Las contrapruebas las decide una persona, separadas de los tests que escribe el agente para su propio código.
- Cada contraprueba apunta a un criterio con ID, con dependencia en un solo sentido y el CI vigilando huérfanas y criterios sin cubrir.
- La ejecución de control antes de implementar, para descartar las contrapruebas que no comprueban nada.
- Feedback en términos de la spec, con un número limitado de intentos y una salida clara cuando no converge.
- Contrapruebas técnicas visibles para las restricciones, y de caracterización para sistemas que ya existen.
Hasta donde he podido revisar, la ejecución de control y el feedback por niveles no tienen un precedente publicado con esta forma. Si conoces alguno, me encantaría que me lo pasaras.
Lo que todavía no sé
DGC es una propuesta y la estoy validando en MaIA, mi software factory de agentes. Hay cosas de las contrapruebas que todavía no tengo resueltas, y prefiero contártelas:
- Ocultar los tests tiene un coste. La investigación muestra que esconderlos reduce las trampas, pero también el rendimiento honesto del agente, que trabaja con menos información. El feedback por criterio intenta compensarlo, pero está por medir cuánto.
- Gherkin no es un escudo. Thoughtworks observó que los agentes engañan con más facilidad a los frameworks BDD genéricos que a montajes de pruebas más simples. En DGC el agente implementador no ve los escenarios, pero los pasos hay que diseñarlos teniéndolo en cuenta.
- ¿Compensa que los escriba una persona? Hay estudios en los que la mayoría de escenarios Gherkin generados por IA se consideran útiles. Yo mantengo al humano por la independencia de interpretación, no por la calidad del texto. Falta medir si compensa lo que cuesta.
En fin. Lo que sí tengo claro es la idea de fondo: para verificar código generado por IA, no le enseñes el examen al agente.
En el próximo artículo de la serie toca el reparto de papeles: qué escribe y qué ve cada uno de los tres actores de DGC, el humano, el agente verificador y el agente implementador, y quién verifica al verificador. Mientras tanto, tienes el método completo, con las contrapruebas y todo lo demás, en la página de DGC.
¡Te espero!