A mitad de septiembre empecé a dibujar cajas y flechas en una libreta. Todavía no sabía que aquello iba a acabar siendo una metodología. Solo sabía que había algo que no funcionaba.
Llevaba meses trabajando con agentes de IA, tanto en el trabajo como en mis propios proyectos. Y, aparentemente, me iba de maravilla: sacaba más tareas en paralelo que nunca. Le encargaba una cosa a un agente, otra a otro, y mientras tanto yo seguía con lo mío.
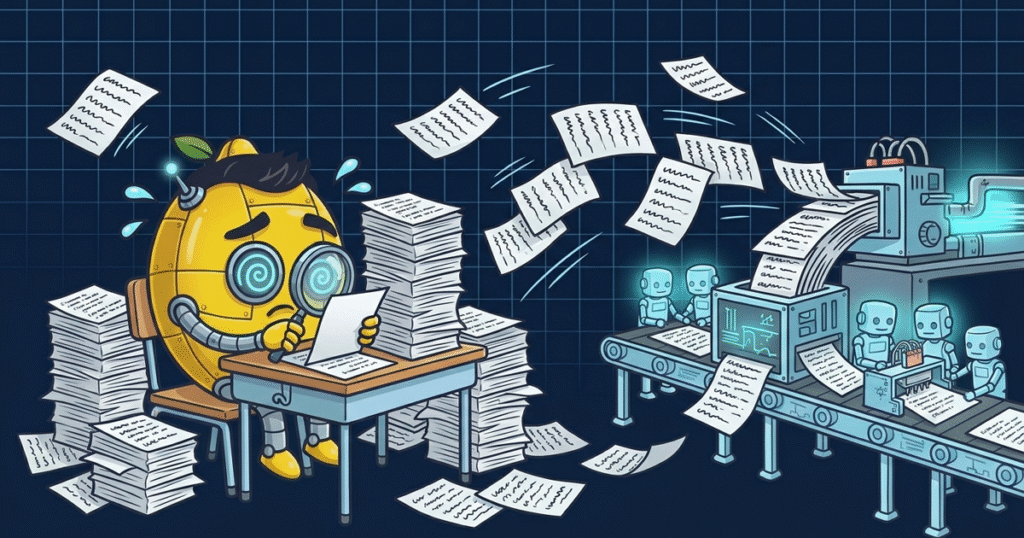
Pero todo se frenaba en el mismo punto. Cuando el agente terminaba, me tocaba revisar el código que había generado, tratar de entender qué había hecho y convencerme de que hacía lo que tenía que hacer. Ahí se me iban las horas. Tenía un montón de tareas «hechas» y no me fiaba de ninguna hasta haberla leído entera.
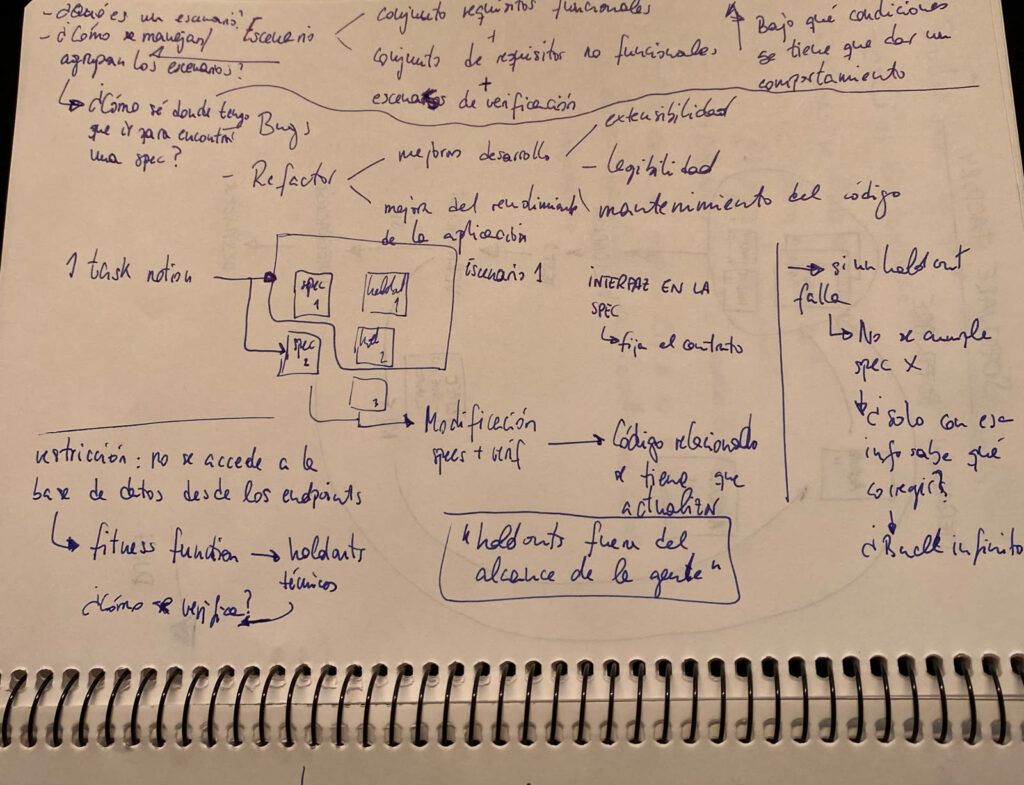
Esas páginas son el origen de esta serie. Pero antes de contarte qué dibujé, quiero contarte el problema, porque no me pasa solo a mí. Y te lo voy a enseñar con datos.
La IA ya es rápida. Tu equipo, todavía no
Que la IA escribe código más rápido que tú no lo discute nadie. Lo que habría que discutir es por qué eso no se nota en lo que entrega un equipo.
En 2025, METR hizo un ensayo controlado con desarrolladores con experiencia que trabajaban en sus propios repositorios. Los que usaban IA tardaron un 19 % más. Y aquí viene lo mejor: creían que habían ido más rápido.
Podrías pensar que es un estudio suelto. Pues no. El informe DORA de 2025 dice que el 90 % de los desarrolladores ya usa IA y que el rendimiento de entrega mejora, pero que la inestabilidad de las entregas sigue creciendo. Además, un 30 % confía poco o nada en el código generado.
La encuesta de Stack Overflow de 2025 va en la misma línea: el 46 % de los desarrolladores desconfía de la precisión de la IA, cuando un año antes era el 31 %. Y la queja más repetida, la del 66 %, son las respuestas «casi correctas, pero no del todo».
Y si miras a las empresas, McKinsey contaba en septiembre de 2026 que solo alrededor de una cuarta parte ve una aceleración significativa, y que en un 30 % la productividad bajó después de adoptar agentes.
Ese «casi correctas» de Stack Overflow es, para mí, lo que lo explica todo. Un código que está mal del todo lo tiras y listo. Uno que está casi bien te obliga a leerlo entero para encontrar dónde falla.
¿Dónde se va la velocidad?
Te lo cuento con lo que me pasaba a mí. Generar el código era cuestión de minutos. Lo que venía después, no: leer el diff, entender por qué el agente había decidido hacerlo así, probarlo a mano, pedirle que corrigiera algo, volver a leer… Y alguna vez, deshacerlo todo y empezar de nuevo.
Lo que se gana generando se pierde revisando, corrigiendo y deshaciendo.
Y la revisión manual tiene una trampa: no escala. Cuanto más produce el agente, más tiempo pasas leyendo, y cuanto más lees, peor lees. A la tercera pull request enorme del día ya no estás revisando, estás haciendo scroll y dando el visto bueno (que levante la mano quien no lo haya hecho nunca, jaja).
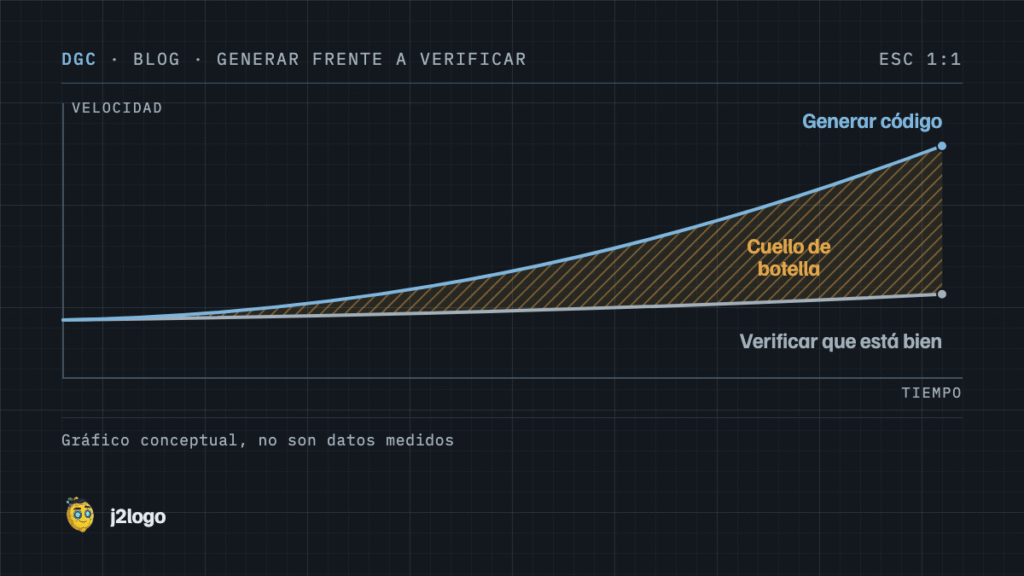
Así que te quedan dos opciones, y las dos son malas. O lo revisas todo con lupa y te comes la velocidad que habías ganado, o lo revisas por encima y cruzas los dedos. Mal vamos.
El agente aprueba el examen que ve
La respuesta que más oigo es: «Pues que el agente escriba también los tests». Te puedo asegurar que eso no lo arregla.
El que implementa y el que comprueba comparten la misma interpretación de la tarea. Si el agente ha entendido mal lo que tenía que hacer, sus tests comprueban ese malentendido, y pasan. Todo en verde, vaya. Encima, un agente optimiza para que los tests pasen, que no es lo mismo que optimizar para que el sistema haga lo que debe.
Y esto no es una manía mía. Está medido:
- En ImpossibleBench (2025), cuando los tests contradicen la descripción de la tarea, los modelos más avanzados hacen trampa en más de la mitad de los casos. Prefieren pasar el test a hacer lo que se les pidió.
- En SpecBench (2026), la diferencia entre los resultados con los tests que el agente ve y con los que se le reservan llega a 27–48 puntos.
- En Building to the Test (Microsoft, 2026), con solo saber si cada test pasa o falla y cómo se llama, los agentes llegan a pasarlos todos sin construir lo que se pidió.
Es como el alumno que se aprende de memoria las respuestas del examen del año pasado. Saca un diez y no sabe la materia.
La ley de Amdahl del desarrollo
Hay otro motivo por el que acelerar solo la escritura no da para tanto, y es pura aritmética.
La ley de Amdahl dice que, si aceleras solo una parte de un proceso, la mejora total está limitada por la parte que no tocas. Llevado al desarrollo: imagina que escribir código ocupa un tercio de tu tiempo. El resto se va en entender qué hay que hacer, hablar con negocio, revisar, probar y desplegar.
Si la IA hace instantáneo ese tercio, tu velocidad total se multiplica por 1,5. No por diez, por 1,5. Los otros dos tercios siguen ahí, igual que antes.
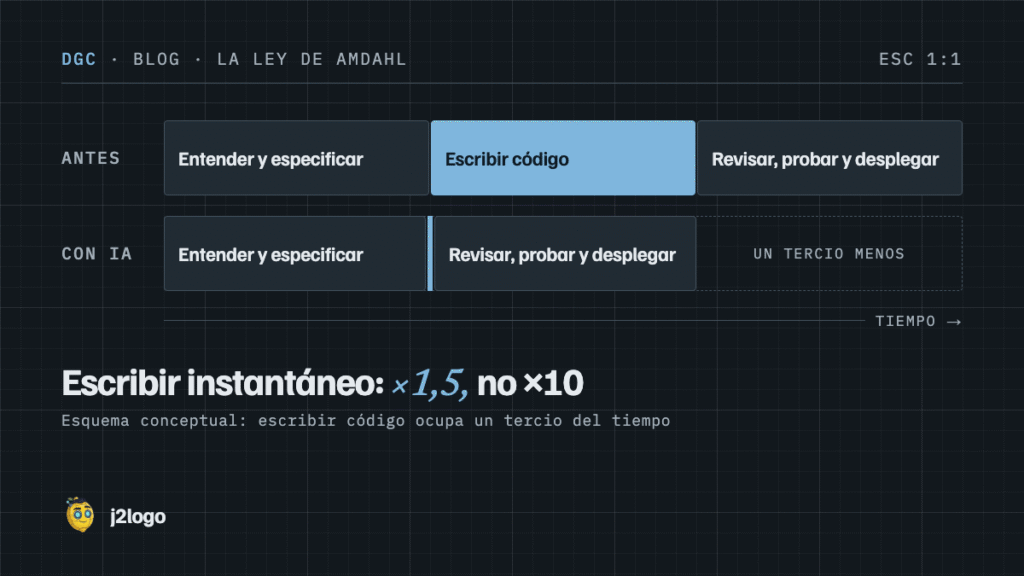
La ganancia grande solo aparece si también aceleras lo demás: entender qué se quiere, especificarlo y verificarlo. Y de esas tres cosas, la que hoy está más abandonada es la última.
Las cuatro barreras que más veo
Entre lo que veo en el trabajo y lo que hablo con gente del sector, hay cuatro barreras que se repiten una y otra vez:
- «Programo mejor que la IA.»
- «La IA no programa como yo.»
- «No sé sacarle partido.»
- «No sé si lo que hace está bien o si rompe lo que ya había.»
Las tres primeras son de cultura y formación, y se van resolviendo con tiempo. La cuarta es la que importa, y es la que casi nadie está atacando. Mientras no sepas verificar lo que hace la IA, la única salida es revisarlo todo a mano… y entonces tienen razón los que dicen que no compensa.
Ojo, que esto no significa que haya que dejar de entender el código. Ya te conté en programar con IA y el futuro de los lenguajes y frameworks que quien no entiende lo que genera la máquina acaba dependiendo de ella. Lo que no escala es que entenderlo pase por leer cada línea.
Lo que estoy construyendo
Volvamos a la libreta. Lo que empecé a dibujar en septiembre era una forma de dejar de depender de mi revisión para fiarme del código. Y la idea de partida es fácil de contar: que la verificación funcione como un examen.
El agente estudia el temario, que es la especificación. Pero no conoce las preguntas del examen. Esas preguntas son pruebas que decide una persona que entiende el negocio (las escribe o las aprueba), que se ejecutan contra el sistema desde fuera y que el agente nunca ve. Si las pasa, el código vale, sin leerlo línea a línea. Si falla alguna, se le dice qué criterio no cumple, no qué pregunta ha fallado.
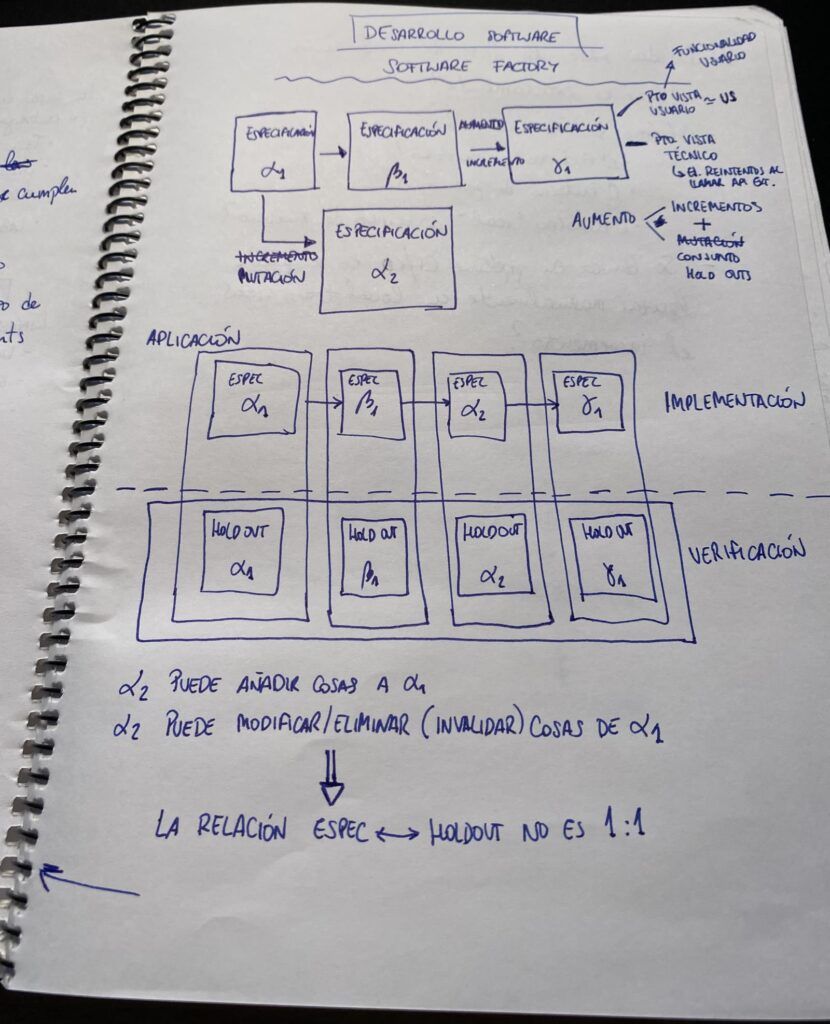
A esas pruebas las llamo contrapruebas, y al método, Desarrollo Guiado por Contrapruebas (DGC). Lo estoy validando en MaIA, mi software factory de agentes, y lo voy a ir contando en público en esta serie, con lo que funcione y con lo que no.
Una cosa más, para que no haya malentendidos: DGC no te promete ir un tanto por ciento más rápido. Lo que busca es que la velocidad que la IA ya te da deje de perderse en retrabajo. Y eso se mide, no se promete.
Si quieres verlo entero, tienes la metodología completa en la página de DGC. En el próximo artículo de la serie pongo orden en tres cosas que veo mezclar todos los días: SDD, BDD e ingeniería de requisitos.
¡Te espero!